경사하강법을 이용한 최적화
이제 우리는 실수값 함수(real-valued function)의 최솟값을 푸는 문제를 고려한다.
여기서 $f : \mathbb{R}^d \rightarrow \mathbb{R}$ 은 당면한 기계 학습 문제를 포착하는 목적 함수(objective function)이다. 우리는 함수 $f$ 가 미분 가능하며, 닫힌 형태(closed form)의 해석적인 해를 찾을 수 없다고 가정한다.
‘닫힌 형태의 해’란 2차 방정식의 근의 공식이나 선형 회귀의 정규 방정식처럼 변수들을 유한 번의 연산으로 도출할 수 있는 해이다. 만약 목적 함수 $f(\boldsymbol{x})$ 의 최솟값을 만드는 $\boldsymbol{x}$ 를 이렇게 계산해 낼 수 있다면, 파라미터를 업데이트하는 최적화 알고리즘은 연산량만 낭비하는 무의미한 행위이다. 따라서 경사 하강법을 논의하기 위해서는 ‘수치적으로 한 번에 해를 구할 수 없다’는 가정이 전제되어야 한다.
목적 함수 $f(\boldsymbol{x})$ 가 최솟값을 가지려면 특정 지점에서 그래디언트가 영벡터( $\nabla f(\boldsymbol{x}) = \boldsymbol{0}$ )가 되어한다. 선형 모델인 경우 단순 2차식을 미분한 1차 연립방정식은 종종 역행렬을 이용해 해를 구할 수 있지만, 비선형 모델의 경우, 신경망의 목적 함수는 수백만 개의 파라미터 $\boldsymbol{x}$ 가 여러 비선형 함수로 합성된 초월 함수이다. 따라서 $\nabla f(\boldsymbol{x}) = \boldsymbol{0}$ 이라는 방정식을 세워도 수치적인 해를 구하는 것이 불가능한 비선형 연립방정식이 된다.
$\quad$ 경사 하강법은 1차 최적화 알고리즘(first-order optimization algorithm)이다. 경사 하강법을 사용하여 함수의 국소 최솟값을 찾기 위해, 현재 지점에서의 함수 기울기의 음수(negative of the gradient)에 비례하는 스텝을 밟는다. [5.1절]에서 기울기는 가장 가파른 상승(steepest ascent) 방향을 가리킨다는 것을 상기하라. 또 다른 유용한 직관은 함수가 특정 값을 가지는 선들의 집합( $f(\boldsymbol{x}) = c$ , 여기서 $c \in \mathbb{R}$ )을 고려하는 것인데, 이는 등고선(contour lines)으로 알려져 있다. 기울기는 우리가 최적화하고자 하는 함수의 등고선과 직교(orthogonal)하는 방향을 가리킨다.
_목적 함수의 등고선은 $f(\boldsymbol{x}) = c$ (상수)로 정의된다. 어떤 위치 $\boldsymbol{x}_0$ 에 있을 때 등고선에 접하는 접선 벡터 $\boldsymbol{v}$ 의 방향으로 이동하면 함수값 $f$ 가 변하지 않는다( $df = 0$ ).
단순한 예시로 2변수 함수 $f(x_1, x_2)$ 의 전미분을 생각해보자. 현재 위치에서 $x_1$ 방향으로 $dx_1$ 만큼, $x_2$ 방향으로 $dx_2$ 만큼 미세하게 이동했다고 가정한다면, 변위 벡터는 $d\boldsymbol{x} = \begin{bmatrix} dx_1 \ dx_2 \end{bmatrix}$ 이다. 이때 전체 함수값의 미세변화량 $df$ 는 다음과 같다.
이를 다음과 같이 표현할 수 있다.
이는 그래디언트와 변위 벡터의 내적이다.
만약 변위 벡터 $d\boldsymbol{x}$ 가 등고선 궤적을 따라 이동한다면, 함수값의 변화량 $df=0$ 이 된다. 즉, $\nabla f \cdot d\boldsymbol{x} = 0$ 임을 의미하며, 이는 영이 아닌 두 벡터가 서로 직교함을 뜻한다.
최적화에서 등고선을 고려해야 하는 이유는, 경사 하강법의 궤적이 결국 매 등고선을 만날 때마다 정확히 90도로 꺾여 나가는 선분들의 집합이기 때문이다. 이는 아래 그림 7.3으로 확인된다.
$\quad$ 다변량 함수를 고려해 보자. 특정 위치 $\boldsymbol{x}_0$ 에서 시작하는 공이 있는 표면(함수 $f(\boldsymbol{x})$ 로 묘사됨)을 상상해 보라. 공을 놓으면, 공은 가장 가파른 하강 방향으로 내리막을 따라 이동할 것이다. 경사 하강법은 어떤 사람이 $\boldsymbol{x}_0$ 에서 $f$ 의 음의 기울기 $-((\nabla f)(\boldsymbol{x}_0))^\top$ 방향으로 이동할 때 $f(\boldsymbol{x}_0)$ 가 가장 빠르게 감소한다는 사실을 이용한다. 이 책에서 우리는 함수들이 미분 가능하다고 가정하며, 독자들에게 7.4절의 더 일반적인 설정을 참고하도록 한다. 그러면 만약
작은 스텝 사이즈(step-size) $\gamma \geqslant 0$ 에 대해, $f(\boldsymbol{x}_1) \leqslant f(\boldsymbol{x}_0)$ 이 성립한다. 차원이 맞지 않기 때문에 기울기에 전치(transpose)를 사용한다는 점에 유의하라. (우리는 기울기에 대해 행 벡터(row vectors) 관례를 사용한다.)
일반적인 경사 하강법의 파라미터 업데이트 과정은 단순 벡터 연산이다.
식 (7.5)에서 $((\nabla f)(\boldsymbol{x}_0))^\top$ 은 $\boldsymbol{x}_0$ 라는 위치에서의 그래디언트 $\nabla f$ 를 의미한다(두 벡터의 곱이 아님).
$\quad$ 이러한 관찰은 우리가 단순한 경사 하강법 알고리즘을 정의할 수 있게 해준다: 만약 우리가 함수 $f : \mathbb{R}^n \rightarrow \mathbb{R}, \boldsymbol{x} \mapsto f(\boldsymbol{x})$ 의 국소 최적값 $f(\boldsymbol{x}_*)$ 를 찾고자 한다면, 우리는 최적화하고자 하는 파라미터의 초기 추정값 $\boldsymbol{x}_0$ 로 시작하여 다음 식에 따라 반복(iterate)한다.
적절한 스텝 사이즈 $\gamma_i$ 에 대해, 수열 $f(\boldsymbol{x}_0) \geqslant f(\boldsymbol{x}_1) \geqslant \dots$ 는 국소 최솟값으로 수렴(converges)한다.
예제 7.1
2차원에서의 2차 함수(quadratic function)를 고려해 보자.
그에 따른 그래디언트는 다음과 같다.
초기 위치 $\boldsymbol{x}_0 = [-3, -1]^\top$ 에서 시작하여, 우리는 (7.6)을 반복적으로 적용하여 최솟값으로 수렴하는 추정값들의 수열을 얻는다(그림 7.3에 예시됨).
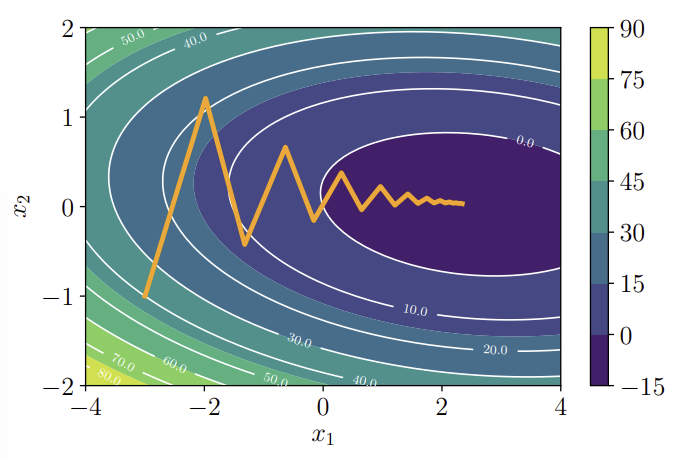
그림 7.3: 2차원 2차 곡면(히트맵으로 표시됨)에서의 경사 하강법. 설명은 예제 7.1을 보라.
우리는 $\boldsymbol{x}_0$ 에서의 음의 그래디언트가 북동쪽을 가리키며 $\boldsymbol{x}_1 = [-1.98, 1.21]^\top$ 로 이어짐을 볼 수 있다 (그림과, 식 (7.8)에 $\gamma=0.085$ 와 함께 $\boldsymbol{x}_0$ 를 대입해 봄으로써 모두 확인 가능). 그 과정을 반복하면 우리는 $\boldsymbol{x}_2 = [-1.32, -0.42]^\top$ 를 얻게 되며, 이런 식으로 계속된다.
_일변수 스칼라 2차 함수 $f(x) = ax^2 + bx + c$ 가 최솟값을 가지려면 최고차항의 계수 $a$ 가 반드시 양수( $a>0$ )여야 한다. 이는 다변수 함수에 경우에도 동일한데, 곡면의 형태를 결정하는 것은 이차항에 곱해진 행렬 $\boldsymbol{A} = \begin{bmatrix} 2 & 1 \ 1 & 20 \end{bmatrix}$ 이며, 이 행렬이 양의 정부호여야만 함수가 아래로 볼록하여 유일한 전역 최솟값을 가진다.
1변수 함수 $f(x)$ 에서 2계 도함수 $f’‘(x) > 0$ 이라는 것은, 함수의 기울기 변화율이 모든 지점에서 양수이므로 기하학적으로 ‘아래로 볼록’한 형태를 띤다.
다변수 함수 $f(\boldsymbol{x})$ 에서 이 2계 도함수의 역할이 이차 미분 행렬인 헤시안 행렬이다. 이차 형식 목적 함수 $f(\boldsymbol{x}) = \frac{1}{2} \boldsymbol{x}^\top \boldsymbol{A} \boldsymbol{x} - \boldsymbol{b}^\top \boldsymbol{x}$ 를 두 번 편미분하면 상수 행렬 $\boldsymbol{A}$ 자체가 도출된다( $\nabla^2 f = \boldsymbol{A}$ ). 즉, 행렬 $\boldsymbol{A}$ 가 양의 정부호라는 것은, 이 다변수 함수의 이계 도함수가 모든 방향에 대해 0보다 크다는 것을 뜻한다._
함수를 두 번 미분하면서 양의 정부호였던 행렬A의 성질이 바뀌는 경우는 없는가? 가령 간단한 예시 $x^{T}Ax$ 에서 x에 대해 두번 미분함으로써 A가 바뀌진 않을까?
주의 (Remark). 경사 하강법은 최솟값 근처에서 상대적으로 느려질 수 있다: 그것의 점근적 수렴 속도(asymptotic rate of convergence)는 다른 많은 방법들보다 열등하다. 언덕을 굴러 내려가는 공의 비유를 사용하자면, 표면이 길고 좁은 계곡(long, thin valley)일 때, 이 문제는 불량 조건(poorly conditioned, Trefethen and Bau III, 1997)이 된다. 불량 조건의 볼록 문제에서, 그래디언트가 최솟값으로 가는 가장 짧은 방향에 거의 직교(orthogonal)하는 방향을 가리키기 때문에 경사 하강법은 점차 “지그재그(zigzags)” 행보를 보이게 된다; 그림 7.3을 참조하라.
‘불량 조건’이란 목적 함수의 헤시안 행렬이 가지는 고윳값들의 편차가 극단적으로 커서, 그래디언트 벡터가 최솟값이 아닌 기울기가 가파른 축으로만 요동치게(지그재그) 만드는 상태를 의미한다. 이는 이후 ‘조건수’의 개념으로 이어진다.
7.1.1 Step-size
스텝 사이즈
앞서 언급했듯이, 경사 하강법에서 좋은 스텝 사이즈를 선택하는 것은 중요하다. 스텝 사이즈가 너무 작으면 경사 하강법은 느려질 수 있다. 스텝 사이즈를 너무 크게 선택하면, 경사 하강법은 목표를 지나치거나(overshoot), 수렴에 실패하거나, 심지어 발산(diverge)할 수 있다. (스텝 사이즈는 학습률(learning rate)이라고도 불린다.) 우리는 다음 절에서 모멘텀(momentum)의 사용에 대해 논의할 것이다. 이는 경사 업데이트의 불규칙한 동작을 부드럽게 하고 진동(oscillations)을 감쇠시키는 방법이다.
$\quad$ 적응형 경사 방법(Adaptive gradient methods)은 함수의 국소적 특성에 따라 매 반복마다 스텝 사이즈를 재조정(rescale)한다. 두 가지 간단한 휴리스틱이 있다 (Toussaint, 2012):
- 경사 스텝 이후 함수값이 증가하면 스텝 사이즈가 너무 컸던 것이다. 스텝을 취소(undo)하고 스텝 사이즈를 줄여라.
- 함수값이 감소하면 스텝이 더 클 수도 있었다. 스텝 사이즈를 늘려보라.
비록 “취소(undo)” 스텝이 자원의 낭비처럼 보일 수 있지만, 이 휴리스틱을 사용하면 단조 수렴(monotonic convergence)을 보장한다.
예제 7.2 (선형 방정식 시스템 풀기)
우리가 $\boldsymbol{A}\boldsymbol{x} = \boldsymbol{b}$ 형태의 선형 방정식을 풀 때, 실제로는 유클리드 노름(Euclidean norm)을 사용한다면 제곱 오차(squared error)를 최소화하는 $\boldsymbol{x}_*$ 를 찾음으로써 $\boldsymbol{A}\boldsymbol{x} - \boldsymbol{b} = \boldsymbol{0}$ 을 근사적으로 푼다.
$\boldsymbol{x}$ 에 대한 식 (7.9)의 그래디언트는 다음과 같다.
우리는 이 그래디언트를 경사 하강법 알고리즘에 직접 사용할 수 있다. 하지만, 이 특정한 특별한 경우에 대해서는 그래디언트를 $0$ 으로 설정하여 찾을 수 있는 해석적인 해(analytic solution)가 존재함이 밝혀져 있다. 제곱 오차 문제를 푸는 것에 대해서는 9장에서 더 자세히 볼 것이다.
_식 7.9와 같은 형태의 목적 함수를 유도하는 이유는, 현실의 거의 모든 데이터 행렬 A가 비가역행렬이기 때문이며, 따라서 True대신 오차가 가장 적은 최선의 근사치를 경사하강법으로 찾기 위함이다. 정답이 존재하지 않기 때문에 임의의 $\boldsymbol{x}$ 를 넣었을 때 좌변 $A\boldsymbol{x}$ 와 우변 $\boldsymbol{b}$ 사이에 반드시 오차가 발생하며, 이 오차 벡터를 잔차(residual) $\boldsymbol{e} = A\boldsymbol{x} - \boldsymbol{b}$ 로 정의한다.
목표는 이 오차 벡터의 길이(크기, $\Vert \boldsymbol{e}\Vert ^2 = \boldsymbol{e}^\top \boldsymbol{e}$ )를 가장 작게 만드는 것이다. 이를 유도하면 아래와 같다.
(미분 상수를 상쇄하는 이유는 따로 정리하였다)
행렬 A가 무엇이든 $A^{\top}A$ 는 무조건 대칭 행렬이며, 양의 준정부호 행렬이다. 즉, 이 함수 $f$ 는 모든 공간에서 아래로 볼록하기 때문에 최적해(True에 근사한)를 구할 수 있다._
주의 (Remark). $\boldsymbol{A}\boldsymbol{x} = \boldsymbol{b}$ 라는 선형 방정식 시스템의 해에 적용될 때, 경사 하강법은 느리게 수렴할 수 있다. 경사 하강법의 수렴 속도는 행렬 $\boldsymbol{A}$ 의 최대 특잇값과 최소 특잇값의 비율인 조건수(condition number) $\kappa = \frac{\sigma(\boldsymbol{A})_{\max}}{\sigma(\boldsymbol{A})_{\min}}$ 에 의존한다 ([4.5절]). 조건수는 본질적으로 가장 많이 구부러진 방향 대 가장 적게 구부러진 방향의 비율을 측정하며, 이는 불량 조건 문제가 길고 좁은 계곡이라는 우리의 심상과 일치한다: 그것들은 한 방향으로는 매우 구부러져 있지만, 다른 방향으로는 매우 평평하다. $\boldsymbol{A}\boldsymbol{x} = \boldsymbol{b}$ 를 직접 푸는 대신, $\boldsymbol{P}^{-1}(\boldsymbol{A}\boldsymbol{x} - \boldsymbol{b}) = \boldsymbol{0}$ 을 풀 수도 있다. 여기서 $\boldsymbol{P}$ 는 사전 조건자(preconditioner)라고 불린다. 목표는 $\boldsymbol{P}^{-1}\boldsymbol{A}$ 가 더 나은 조건수를 가지면서 동시에 $\boldsymbol{P}^{-1}$ 을 계산하기 쉽도록 $\boldsymbol{P}^{-1}$ 을 설계하는 것이다.
_최대 특이값( $\sigma_{\max}$ )은 행렬 행렬 $\boldsymbol{A}$ 가 공간을 변환할 때, 가장 강하게 팽창시키는 방향의 스케일(가장 가파른 곡률)이며, 최소 특이값( $\sigma_{\min}$ )은 행렬 $\boldsymbol{A}$ 가 가장 약하게 변환시키는 방향의 스케일(가장 완만한 곡률)이다. 이 둘의 비율인 조건수 $\kappa$ 는 “이 다변수 지형이 둥근 밥그릇( $\kappa \approx 1$ )에 가까운가, 아니면 좁고 길쭉하게 찌그러진 계곡( $\kappa \gg 1$ )에 가까운가?”를 측정하는 지수이다. 만약 조건수가 매우 큰 경우( $\kappa = 1000$ ) 그래디언트는 바닥의 중심을 향하지 않고, 양쪽 벽면을 향해 튕기기 때문에 (지그재그로) 경사 하강법이 느리게 수렴한다.
파라미터가 이러한 불량 조건 하에서 움직이는게 아닌 형태 자체를 밥그릇(이거밖에 표현이 생각나지 않는다)으로 만들기 위해 $\boldsymbol{A}\boldsymbol{x} - \boldsymbol{b} = \boldsymbol{0}$ 양변에 새로운 정방 행렬 $\boldsymbol{P}^{-1}$ 를 곱한다. 기하학적으로, $\boldsymbol{P}^{-1}$ 은 가파른 곡률은 보다 완만하게, 평평한 축은 보다 가파르게 하여 그래디언트가 최적점을 향하도록 유도한다._
7.1.2 Gradient Descent With Momentum
모멘텀을 동반한 경사 하강법
그림 7.3에 예시된 바와 같이, 최적화 표면의 곡률이 불량하게 스케일된(poorly scaled) 영역이 존재한다면 경사 하강법의 수렴은 매우 느려질 수 있다. 이 곡률 때문에 경사 하강법 스텝은 계곡의 벽 사이를 널뛰기(hops)하며, 작은 스텝으로 최적값에 접근하게 된다. 수렴을 개선하기 위해 제안된 조작(tweak)은 경사 하강법에 약간의 기억(memory)을 부여하는 것이다. (Goh (2017)는 모멘텀을 동반한 경사 하강법에 대한 직관적인 블로그 포스트를 작성했다.)
$\quad$ 모멘텀을 동반한 경사 하강법(Rumelhart et al., 1986)은 이전 반복(iteration)에서 일어났던 일을 기억하기 위해 추가적인 항(term)을 도입하는 방법이다. 이 기억은 진동(oscillations)을 감쇠시키고 그래디언트 업데이트를 부드럽게 만든다. 공의 비유를 이어가자면, 모멘텀 항은 방향을 바꾸기를 꺼리는 무거운 공의 현상을 모방한다. 핵심 아이디어는 이동 평균(moving average)을 구현하기 위해 기억을 가진 그래디언트 업데이트를 수행하는 것이다. 모멘텀 기반 방법은 매 반복 $i$ 마다의 업데이트 $\Delta \boldsymbol{x}_i$ 를 기억하고, 현재와 이전 그래디언트들의 선형 결합(linear combination)으로 다음 업데이트를 결정한다.
여기서 $\alpha \in [0, 1]$ 이다. 때때로 우리는 그래디언트를 단지 근사적으로만 알게 될 것이다. 그러한 경우, 모멘텀 항은 그래디언트의 각기 다른 노이즈가 섞인 추정치들을 평균 내어 상쇄시키기 때문에 유용하다. 근사적인 그래디언트를 얻는 특히 유용한 한 가지 방법은 확률적 근사(stochastic approximation)를 사용하는 것이며, 이에 대해서는 다음에 논의한다.
_그림 7.3을 보면 초기 불필요한 step 반경으로 파라미터가 업데이트되는 연산이 요구되지만, $\boldsymbol{x}_i - \boldsymbol{x}_{i-1}$ 라는 벡터 연산으로 이전 step과 방향이 다르다면 상쇄되어 불필요한 이동이 보다 완화되고, 이전 step과 방향이 비슷하다면 증폭되어 더욱 수렴 속도가 빨라진다.
7.1.3 Stochastic Gradient Descent
확률적 경사 하강법
그래디언트를 계산하는 것은 시간이 매우 많이 소요될 수 있다. 하지만, 종종 그래디언트의 “값싼(cheap)” 근사치를 찾는 것이 가능하다. 근사된 그래디언트가 진짜 그래디언트와 대략적으로 같은 방향을 가리키는 한, 그것을 근사하는 것은 여전히 유용하다.
$\quad$ 확률적 경사 하강법(종종 SGD로 줄여 씀)은 미분 가능한 함수들의 합으로 쓰인 목적 함수를 최소화하기 위한 경사 하강법의 확률적 근사(stochastic approximation)이다. 여기서 ‘확률적(stochastic)’이라는 단어는 우리가 그래디언트를 정확하게 알지 못하며, 대신 노이즈가 섞인 근사치만을 안다는 사실을 인정한다는 것을 의미한다. 근사된 그래디언트들의 확률 분포를 제약(constraining)함으로써, 우리는 SGD가 수렴할 것이라는 점을 이론적으로 여전히 보장할 수 있다.
$\quad$ 기계 학습에서, $n = 1, \dots, N$ 개의 데이터 포인트가 주어졌을 때 우리는 종종 각 예제 $n$ 에 의해 발생한 손실(losses) $L_n$ 들의 합인 목적 함수를 고려한다. 수학적 표기법으로 우리는 다음과 같은 형태를 갖는다.
여기서 $\boldsymbol{\theta}$ 는 관심 있는 파라미터들의 벡터이다. 즉, 우리는 $L$ 을 최소화하는 $\boldsymbol{\theta}$ 를 찾고자 한다. 회귀(Regression, 9장)에서의 한 예는 음의 로그 가능도(negative log-likelihood)이며, 이는 개별 예제들의 로그 가능도에 대한 합으로 표현되어 다음과 같이 된다.
여기서 $\boldsymbol{x}_n \in \mathbb{R}^D$ 는 훈련 입력(training inputs), $y_n$ 은 훈련 타깃(training targets), 그리고 $\boldsymbol{\theta}$ 는 회귀 모델의 파라미터이다.
$\quad$ 이전에 소개된 표준 경사 하강법은 “배치(batch)” 최적화 방법이다. 즉, 최적화는 다음과 같이 파라미터 벡터를 업데이트함으로써 전체 훈련 세트를 사용하여 수행된다.
적절한 스텝 사이즈 파라미터 $\gamma_i$ 에 대해 말이다. 이 합(sum) 그래디언트를 평가하는 것은 모든 개별 함수 $L_n$ 들로부터 그래디언트를 평가해야 하므로 비용이 많이 들 수 있다. 훈련 세트가 엄청나게 크고/크거나 간단한 공식이 존재하지 않을 때, 그래디언트들의 합을 평가하는 것은 매우 비싸진다.
$\quad$ 식 (7.15)의 항 $\sum_{n=1}^N (\nabla L_n(\boldsymbol{\theta}_i))$ 를 고려해 보자. 우리는 $L_n$ 의 더 작은 집합(smaller set)에 대해 합을 취함으로써 연산량을 줄일 수 있다. $n = 1, \dots, N$ 에 대해 모든 $L_n$ 을 사용하는 배치 경사 하강법과 대조적으로, 우리는 미니 배치 경사 하강법(mini-batch gradient descent)을 위해 $L_n$ 의 부분 집합(subset)을 무작위로 선택한다. 극단적인 경우, 우리는 그래디언트를 추정하기 위해 무작위로 오직 단 하나의 $L_n$ 만을 선택할 수도 있다. 데이터의 부분 집합을 취하는 것이 왜 합리적인지에 대한 핵심 통찰은, 경사 하강법이 수렴하기 위해서는 오직 그래디언트가 진짜 그래디언트의 ‘불편 추정량(unbiased estimate)’이기만 하면 된다는 것을 깨닫는 데 있다. 사실 식 (7.15)의 $\sum_{n=1}^N (\nabla L_n(\boldsymbol{\theta}_i))$ 항은 그래디언트의 기댓값(Expected Value, 6.4.1절)에 대한 경험적 추정치(empirical estimate)이다. 따라서 기댓값에 대한 그 어떤 다른 불편 경험적 추정치(예를 들어 데이터의 임의의 서브샘플을 사용하는 것)라도 경사 하강법의 수렴을 위해 충분할 것이다.
주의 (Remark). 학습률이 적절한 속도로 감소하고, 비교적 온건한 가정(mild assumptions)들을 만족할 때, 확률적 경사 하강법은 거의 확실하게(almost surely) 국소 최솟값으로 수렴한다 (Bottou, 1998).
전체 데이터셋을 배치로 나눠 각 배치의 그래디언트를 찾아 최적화하는게 과적합을 보다 방지할 수 있다. 왜? 전체 데이터의 그래디언트를 구해 파라미터를 업데이트하면, 현재 데이터셋의 fit되어진 파라미터를 찾기 때문이다. 반면, 일정 묶음에 대해 그래디언트를 구한다면, 이전보다 노이즈는 생길 수 있지만, 전체가 아닌 무작위 샘플에 대해 파라미터를 최적화하기 때문에 보다 일반화된 학습이 가능하다.
$\quad$ 왜 우리는 근사된(approximate) 그래디언트를 사용하는 것을 고려해야 하는가? 한 가지 주요한 이유는 중앙 처리 장치(CPU)나 그래픽 처리 장치(GPU)의 메모리 크기, 또는 연산 시간에 대한 한계와 같은 실용적인 구현상의 제약(constraints) 때문이다. 우리는 그래디언트를 추정하는 데 사용되는 부분 집합(subset)의 크기를, 경험적 평균(empirical means, 6.4.1절)을 추정할 때 표본(sample)의 크기를 생각했던 것과 동일한 방식으로 생각할 수 있다. 큰 미니 배치 크기는 그래디언트에 대한 정확한 추정치를 제공하여, 파라미터 업데이트 시 발생하는 분산(variance)을 줄여준다. 게다가, 큰 미니 배치는 비용(cost)과 그래디언트의 벡터화된(vectorized) 구현에서 고도로 최적화된 행렬 연산의 이점을 활용한다. 분산의 감소는 더 안정적인 수렴으로 이끌지만, 각각의 그래디언트 계산은 더 비싸질 것이다.
연산 속도 측면에서 전체 데이터셋에 대한 그래디언트를 구하는 것보다 배치로 나눠 각 배치당 그래디언트를 더 많이 연산하는게 더 효율적임을 말한다.
$\quad$ 대조적으로, 작은 미니 배치는 추정하기가 빠르다. 만약 우리가 미니 배치의 크기를 작게 유지한다면, 우리의 그래디언트 추정치에 섞여 있는 노이즈(noise)는 우리가 갇힐 수도 있었던 몇몇 나쁜 국소 최적값(bad local optima)으로부터 빠져나오게(get out of) 해줄 것이다. 기계 학습에서, 훈련 데이터에 대한 목적 함수를 최소화함으로써 훈련을 수행하기 위해 최적화 방법들이 사용되지만, 전반적인 목표는 일반화 성능(generalization performance, 8장)을 향상시키는 것이다. 기계 학습의 목표가 반드시 목적 함수의 최솟값에 대한 정밀한(precise) 추정을 필요로 하지는 않기 때문에, 미니 배치 접근법을 사용한 근사적인 그래디언트가 널리 사용되어 왔다. 확률적 경사 하강법은 수백만 장의 이미지에 대해 깊은 신경망을 훈련하거나(Dean et al., 2012), 토픽 모델(Hoffman et al., 2013), 강화 학습(Mnih et al., 2015), 대규모 가우시안 프로세스 모델의 훈련(Hensman et al., 2013; Gal et al., 2014)과 같은 대규모 기계 학습 문제에서 매우 효과적이다.
“기계학습의 목표가 반드시 목적 함수의 최솟값에 대한 정밀한 추정을 필요로 하지는 않기 때문에”라는 의미는 어차피 모델은 테스트 환경에서 훈련 데이터의 지형과 약간 다른 지형을 볼 것이므로, 현재 지형에 fit하기보다는 노이즈를 견뎌내며 강건한 성능을 유지하는 것이 목표이다.
_확률적 경사하강법이 수렴하기 위한 전제 조건은 그래디언트가 불편(unbiased, 치우치지 않음) 추정량이어야 한다. 따라서 미니배치는 고정된 묶음(순서를 고려)이 아니라, 매 학습 주기마다 데이터를 무작위로 뒤섞은 뒤에 잘라낸 ‘확률적 표본의 묶음’으로 정의해야하는데, 이 말은 모든 표본이 i.i.d.에서 추출되어야 한다는 것을 뜻한다.
우리가 알고자 하는 모집단의 True 파라미터(모수)를 $\theta$ 라고 하고, 일부 표본(미니 배치)만 뽑아서 모수를 대략적으로 계산한 추정량은 $\hat{\theta}$ 라고 해보자. 이때 표본으로 계산한 추정량들의 기댓값( $\mathbb{E}[\hat{\theta}] = \theta$ )이 실제 모집단의 true 파라미터 $\theta$ 와 일치하다면, 그 결과를 ‘불편(unbiased) 추정량’이라고 한다._